
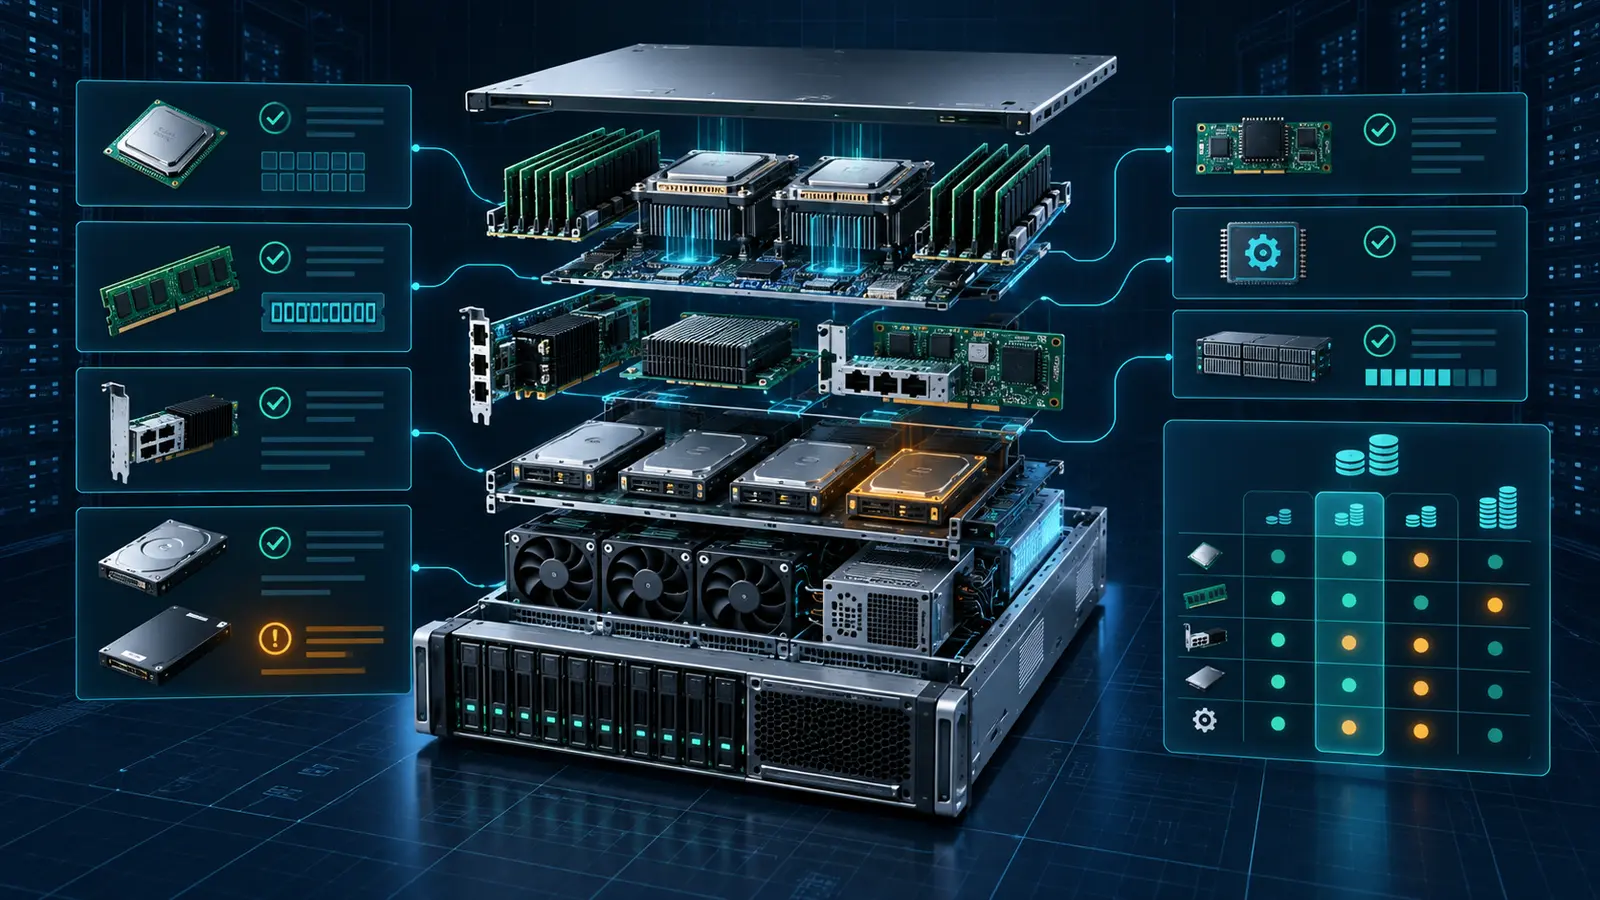
خلاصه اجرایی: Hardware Readiness پاسخ دوحالتی «سازگار/ناسازگار» نیست. باید معلوم شود کدام Host بدون تغییر قابل حفظ است، کدام به Remediation نیاز دارد و کدام باید تعویض شود. نتیجه باید با Evidence، Owner، هزینه، زمان و اثر بر Upgrade یا Greenfield همراه باشد.
HCL چه میگوید و چه چیزی را تضمین نمیکند؟
Compatibility Guide نشان میدهد یک ترکیب مشخص در شرایط و نسخهای مشخص پشتیبانی شده است. اما دیدن نام مدل Server بهتنهایی کافی نیست. ممکن است همان مدل با CPU Generation، NIC، Controller، Firmware یا Boot Device متفاوتی در دیتاسنتر باشد. همچنین «پشتیبانیشدن» الزاماً به معنی مناسببودن ظرفیت برای معماری مقصد نیست.
سه سؤال باید جدا پاسخ داده شود: آیا ترکیب فعلی Supported است؟ آیا برای Target Release Supported میماند؟ آیا از نظر ظرفیت و Lifecycle ارزش نگهداری دارد؟
تیم مدل شاسی را در HCL پیدا میکند و نتیجه را برای کل Host قطعی میداند؛ در حالی که جزء تعیینکننده میتواند NIC Driver یا Storage Controller باشد.
هر Host را بهصورت یک Stack ببینید
Platform
Vendor، مدل، Generation، Support Contract، BIOS و مدیریت Out-of-band.
Compute
CPU Model/Generation، Core، NUMA، Memory Population و ظرفیت واقعی.
Network
NIC Model، Firmware، Driver، Speed، Port count، Offload و Redundancy.
Storage
Controller/HBA، Firmware، Driver، Drive model، Endurance و معماری vSAN یا External Storage.
Validation باید برای Bill of Materials واقعی انجام شود. یک Cluster ممکن است ظاهراً همگن باشد اما طی سالها قطعات متفاوت گرفته باشد؛ این Drift باید Host-by-Host ثبت شود.
CPU، ظرفیت و Licensing را همزمان بسنجید
CPU قدیمی ممکن است با نسخه هدف سازگار نباشد؛ CPU جدید پرهسته نیز ممکن است Core Scope را بالا ببرد. در طراحی جایگزین باید Performance، Consolidation ratio، Failure domain، NUMA و هزینه تجاری کنار هم دیده شوند.
| تصمیم CPU | مزیت احتمالی | ریسک احتمالی | Evidence لازم |
|---|---|---|---|
| حفظ Host فعلی | کاهش Capex و زمان | عمر کوتاهتر و محدودیت Release بعدی | Compatibility + Support lifecycle |
| CPU پرهستهتر | Consolidation و ظرفیت بیشتر | Core cost و Blast radius | Performance baseline + BOM تجاری |
| Host بیشتر با Core کمتر | انعطاف Maintenance | پیچیدگی و تجهیزات بیشتر | HA model + Rack/Power/Network |
برای Workloadهای خاص مانند Database یا AI، متوسط CPU utilization کافی نیست. Peak، Ready time، Memory bandwidth، NUMA locality و سیاستهای Vendor اپلیکیشن باید بررسی شوند.
Firmware و Driver یک زوجاند
بهروزرسانی مستقل Firmware یا Driver بدون ماتریس سازنده میتواند ترکیب پشتیبانینشده بسازد. Baseline باید شامل BIOS، BMC، NIC، Controller، Drive Firmware و ESXi Driver باشد. اگر Vendor Custom Image یا Add-on استفاده میشود، نسخه آن نیز بخشی از تصمیم است.
Collect
Inventory خودکار را با Export سازنده و بازبینی نمونهای تطبیق دهید.
Normalize
نامها، Revisionها و Host groupها را یکسان کنید تا Drift پنهان نماند.
Map
هر ترکیب را به Target Release، Vendor Recipe و Compatibility Guide وصل کنید.
Remediate
ترتیب، Reboot، Downtime و Rollback/Recovery هر Firmware wave را ثبت کنید.
NIC و Underlay؛ گلوگاه پنهان VCF
تعداد Port و سرعت اسمی همه داستان نیست. Redundancy واقعی، MTU end-to-end، Queue/Buffer، Offload، Driver/Firmware، VLAN availability و مسیرهای Management، vMotion، vSAN و Overlay باید دیده شوند. اگر NSX Edge یا Storage traffic اضافه میشود، Oversubscription و failure scenario اهمیت بیشتری پیدا میکند.
یک تست Ping با Jumbo frame جای طراحی شبکه را نمیگیرد. مسیر باید از Host تا Switch و مقصد بررسی شود و نتیجه روی هر Uplink و Failover path اعتبارسنجی شود.
Storage Controller و Drive را جداگانه بررسی کنید
در vSAN، Controller mode، Queue depth، Firmware، Driver، Drive model، Endurance، Cache/Capacity role و Failure Domain روی پشتیبانی و عملکرد اثر دارند. در External Storage نیز HBA، Multipathing، Array code و Pluginها باید با مقصد سازگار باشند.
| حوزه | پرسش آمادگی | ریسک در صورت پاسخ مبهم |
|---|---|---|
| Controller/HBA | ترکیب Firmware/Driver و Mode رسمی چیست؟ | Latency، APD/PDL یا پشتیبانینشدن |
| Drive | مدل دقیق، Firmware و Endurance کافی است؟ | Failure زودرس یا ظرفیت ناپایدار |
| Capacity | پس از FTT، Slack و رشد چقدر قابلاستفاده میماند؟ | ناتوانی در Rebuild و Maintenance |
| Network | Bandwidth و Redundancy در Failure سنجیده شده؟ | Resync طولانی و افت Workload |
Boot، TPM و اجزای «کوچک» را دستکم نگیرید
Boot Device فرسوده، ظرفیت کم Scratch/Logging، تنظیمات Secure Boot یا TPM و ناسازگاری ابزار مدیریت سختافزار میتوانند Upgrade را متوقف کنند. این موارد معمولاً در High-level Inventory دیده نمیشوند اما در Precheck یا هنگام نصب خود را نشان میدهند.
برای هر Host باید Boot architecture، سلامت Device، مسیر Log، وضعیت TPM/Secure Boot و روش Recovery مستند باشد. تغییر BIOS Profile نیز میتواند Performance یا Availability را تغییر دهد و باید کنترلشده اجرا شود.
Compatibility بدون Headroom، آمادگی نیست
در زمان Maintenance، یک یا چند Host از مدار خارج میشوند. Cluster باید بتواند Workload و سرویسهای پلتفرم را با سطح قابل قبول نگه دارد. محاسبه Headroom باید Peak واقعی، Reservation، Failover policy، vSAN rebuild، رشد و سرویسهای مدیریتی را در نظر بگیرد.
ظرفیت خام منهای HA، Failure tolerance، Overhead، Slack عملیاتی و رشد برنامهریزیشده است. درصد ثابت عمومی جای تحلیل Workload را نمیگیرد.
فقط نسخه هدف امروز را نبینید
Host ممکن است VCF مقصد را پشتیبانی کند اما در آستانه پایان Support سازنده باشد. اگر ارتقا چند ماه زمان ببرد، سازمان با فاصله کمی دوباره به پروژه تعویض میرسد. Hardware Decision باید افق ۲۴ تا ۳۶ ماه، دسترسی قطعه، Firmware cadence و قرارداد پشتیبانی را هم بررسی کند.
این نگاه از دو خرید پرهزینه جلوگیری میکند: خرید عجولانه سختافزار بیش از نیاز و نگهداشتن تجهیزی که خیلی زود مانع Lifecycle بعدی میشود.
Keep، Remediate یا Replace؟
Keep
پشتیبانی، ظرفیت و عمر مفید کافی است؛ فقط Baseline و Monitoring تثبیت میشود.
Remediate
با Firmware، Driver، NIC/Drive replacement یا تغییر پیکربندی قابل اصلاح است.
Replace
ناسازگاری بنیادین، ظرفیت ناکافی یا Lifecycle کوتاه، نگهداری را غیرمنطقی میکند.
هر تصمیم باید دلیل، هزینه تقریبی، Lead time، Dependency و اثر بر مسیر Upgrade/Greenfield داشته باشد. «قدیمی است» یا «هنوز کار میکند» هیچکدام Evidence کافی نیستند.
Hardware Readiness Workbook چه خروجی دارد؟
- Inventory دقیق Host و Component با Freeze Date؛
- Target Release و Compatibility reference برای هر جزء؛
- Firmware/Driver Baseline و Drift report؛
- Capacity و Headroom در Normal، Maintenance و Failure؛
- Remediation backlog با Owner، زمان و Change impact؛
- Keep/Fix/Replace decision به تفکیک Host group؛
- Technical BOM و ورودی لازم برای Commercial BOM؛
- ریسکها و مواردی که نیاز به تأیید Vendor دارند.
پرسشهای متداول
اگر Server در HCL باشد، VCF آماده است؟
خیر. باید Component، Firmware/Driver، نسخه هدف، ظرفیت و Lifecycle نیز بررسی شوند.
آیا همه Hostهای یک Cluster باید دقیقاً یکسان باشند؟
همگنی عملیات را ساده میکند، اما قاعده دقیق به قابلیت، Compatibility و طراحی بستگی دارد. Drift باید شناخته و مستند باشد.
آیا Firmware را میتوان همزمان با Upgrade انجام داد؟
گاهی ممکن است، اما ترتیب و ترکیب باید با Vendor recipe و Runbook نسخه هماهنگ باشد. Wave جدا میتواند ریسک را کاهش دهد.
آیا ظرفیت آزاد vCenter برای Sizing کافی است؟
نه. Peak، Reservation، HA، vSAN policy، Maintenance و رشد باید وارد محاسبه شوند.
منابع رسمی و یادداشت تحریریه
مرجع نهایی سازگاری، Compatibility Guide و Firmware recipe سازنده برای مدل و Build واقعی سازمان است.
برای مطالعه بعدی
Hardware را قبل از Upgrade غربال کنید
با Inventory واقعی مشخص کنید کدام Host قابل حفظ، کدام نیازمند اصلاح و کدام مانع نسخه هدف است.